 Aniv AI
註冊贈送 40 積分
用 MiniMax 開源權重影像模型 MiniMax H3 Image,線上文生圖、生成 4K 大圖,並上傳參考圖編輯。
MiniMax H3 Image 是 MiniMax 於 2026 年 11 月 11 日釋出的開源權重影像模型。它基於 MiniMax H3,把文生圖、參考圖生成與影像編輯放進同一個模型,並在所有畫幅下原生輸出約 1600 萬畫素。MiniMax 改進了整條後訓練鏈路,從資料、強化學習到減少採樣步數、提示詞增強和部署最佳化,讓速度、畫質與提示詞遵循同時提升,而不是此消彼長。
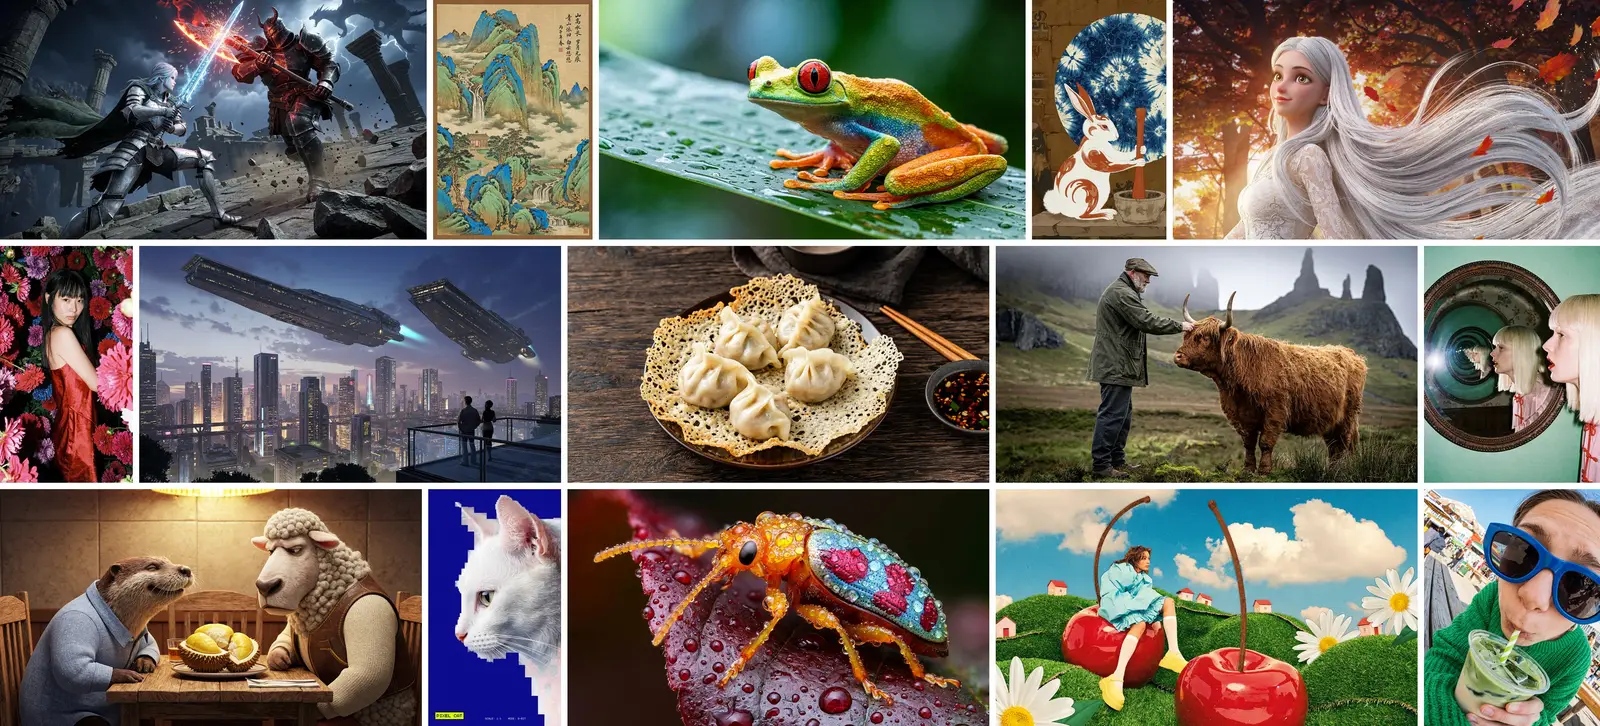
根據 MiniMax 官方釋出部落格、模型卡,以及 Aniv 所用介面服務商 Evolink 的模型資料,整理 MiniMax H3 Image 的主要特點。
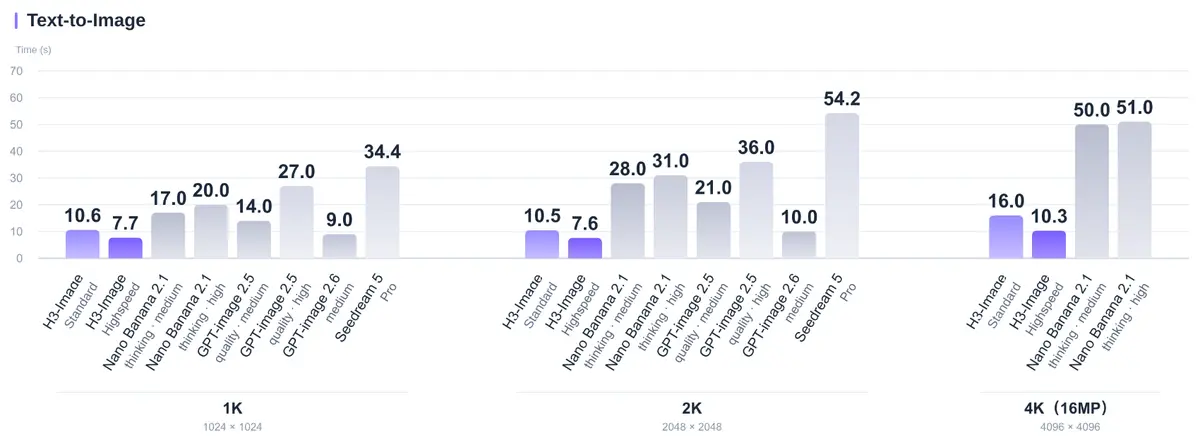
大多數影像模型解析度一高就明顯變慢。MiniMax 官方延遲測試(文生圖,中位數)中,H3 Image 標準版 1K、2K 約 10.5 秒,完整 4096 × 4096 的 4K 約 16 秒,而對比中的其他模型生成 4K 需要 50 秒以上。MiniMax 的 Highspeed 極速版可把 4K 壓到約 10 秒。
由於 1K 和 2K 耗時幾乎一樣,反覆試稿時也不必為了速度降低解析度。Aniv 使用的是標準版,排隊和儲存結果會在 MiniMax 實測時間上再多幾秒。
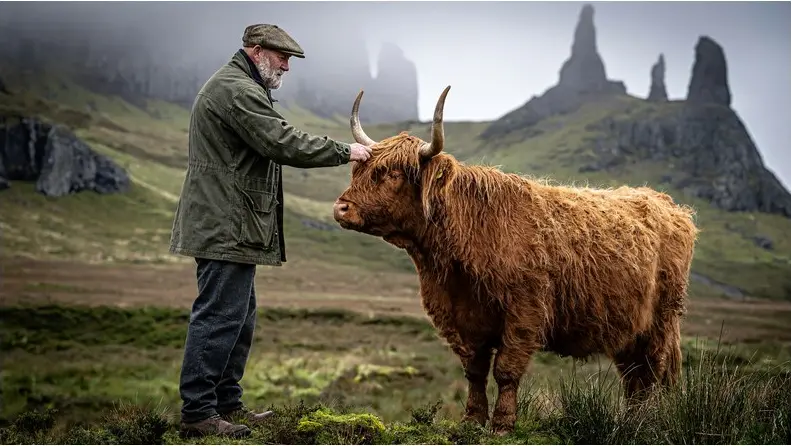
MiniMax 的目標是縮小生成影像與真實世界之間的差距。H3 Image 保留了其他模型容易抹平的細微質感:溼漉漉的毛髮、羊毛、飽經風霜的皮膚、布料紋理、山間薄霧。光線也像真實照片那樣自然,而不是許多 AI 圖那種過亮、過於均勻的光澤感。
解析度同樣重要。模型在所有畫幅下都原生輸出約 1600 萬畫素,從 4096 × 4096 方圖到 21:9 的 6272 × 2688,不依賴超分放大,細節由模型本身畫出,而不是靠後期增強補出來。
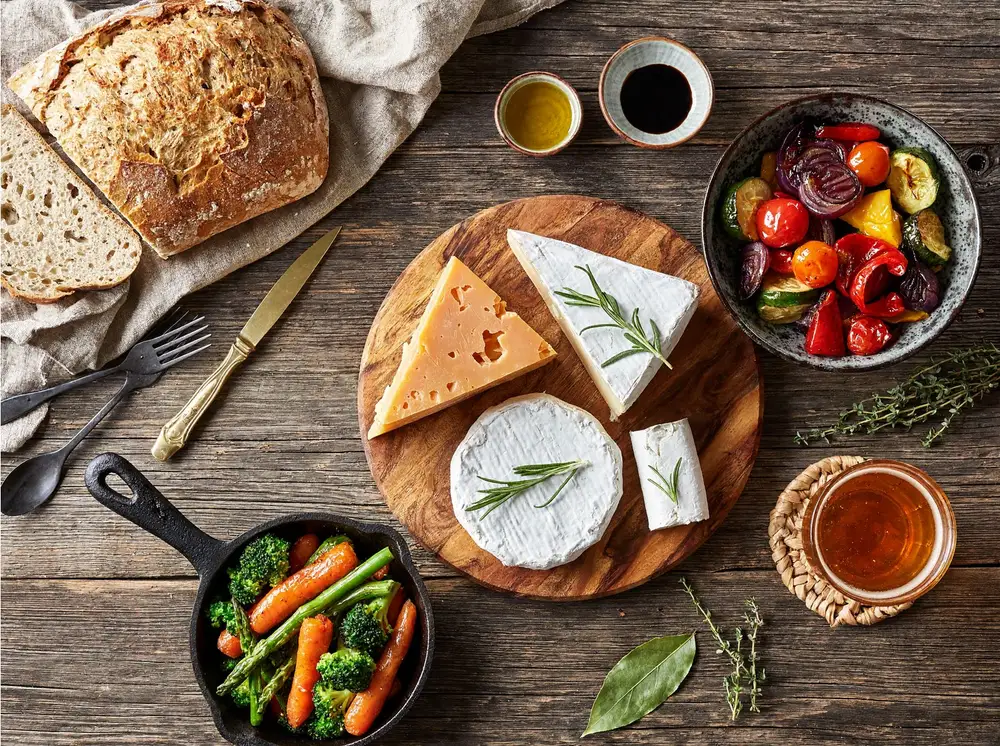
H3 Image 最適合根據一段完整、詳細的畫面描述來生成,但你不必自己寫。生成前,MiniMax 的提示詞最佳化會把任意語言的短提示詞擴寫成完整描述,涵蓋主體、構圖、光線、材質和氛圍;畫幅選「自動」時,還會挑選合適的比例。
這張圖就是 MiniMax 官方示例:原始提示詞只有一句「俯拍一桌鄉村風格的農場直供盛宴」,配上蔬菜、乳酪和麵包,生成前被擴寫成約 300 詞的詳細描述。在 Aniv 上提示詞最佳化始終開啟,寫短句就夠了,只在你在意的地方補充細節即可。
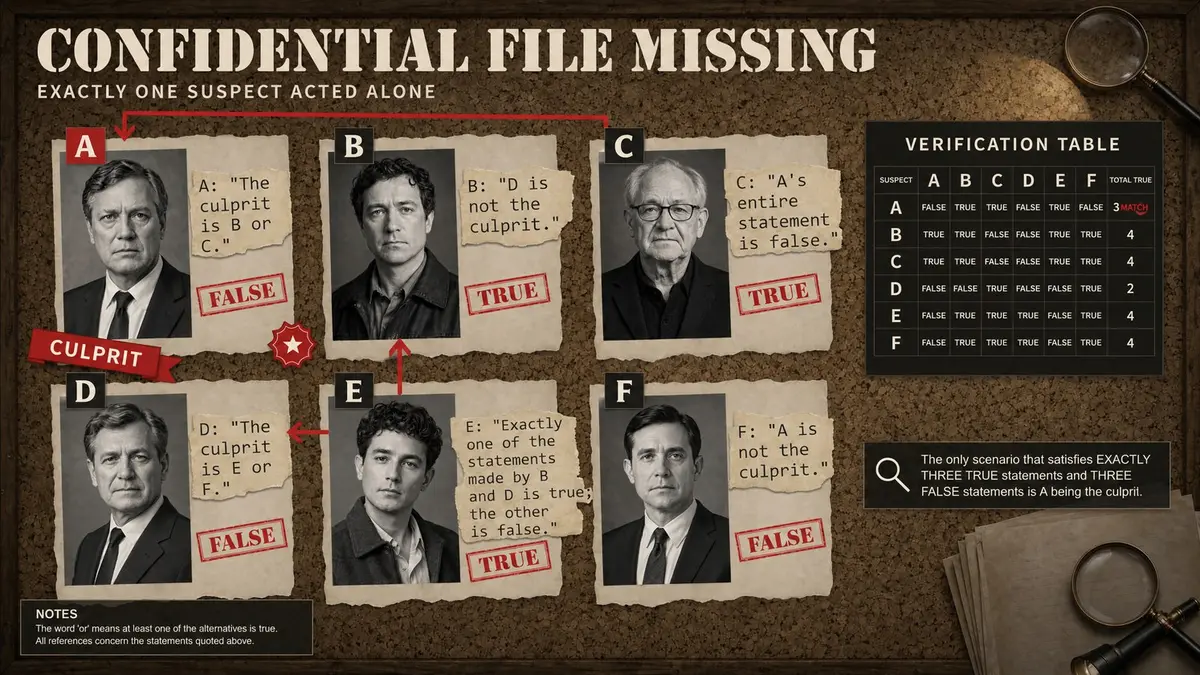
海報、資訊圖和招牌上的文字既要寫對,也要內容正確。H3 Image 能清晰渲染大段中英文,MiniMax 還更進一步:官方示例中,模型在畫面上排出整道邏輯推理題,逐條推理並把正確答案寫在板上。
因此它適合各種以文字為主的畫面,比如選單、商品標籤、活動海報、幻燈片和漫畫分格。在提示詞裡用引號寫出準確文字,並說明位置和字型風格。
H3 Image 屬於 MiniMax H3 家族,沿用 H3 架構但去掉了音訊層:331 億引數、50 層的擴散 Transformer,H3 文本編碼器(基於 Qwen3-VL)和影像 VAE。模型被蒸餾到只需 6 步取樣、無需無分類器引導,這也是它速度快的重要原因。
MiniMax 已在 Hugging Face 以 MiniMax-H3-Image 社群許可協議釋出權重,支援 diffusers、SGLang、vLLM-Omni 和 ComfyUI。自行部署需要資料中心級 GPU;在 Aniv 上,開啟瀏覽器就能用託管好的模型,無需安裝。
以下為 MiniMax 官方樣例,每個都附有一句可在上方生成器裡直接改寫使用的提示詞,覆蓋從攝影到概念設計、傳統繪畫等模型擅長的方向。
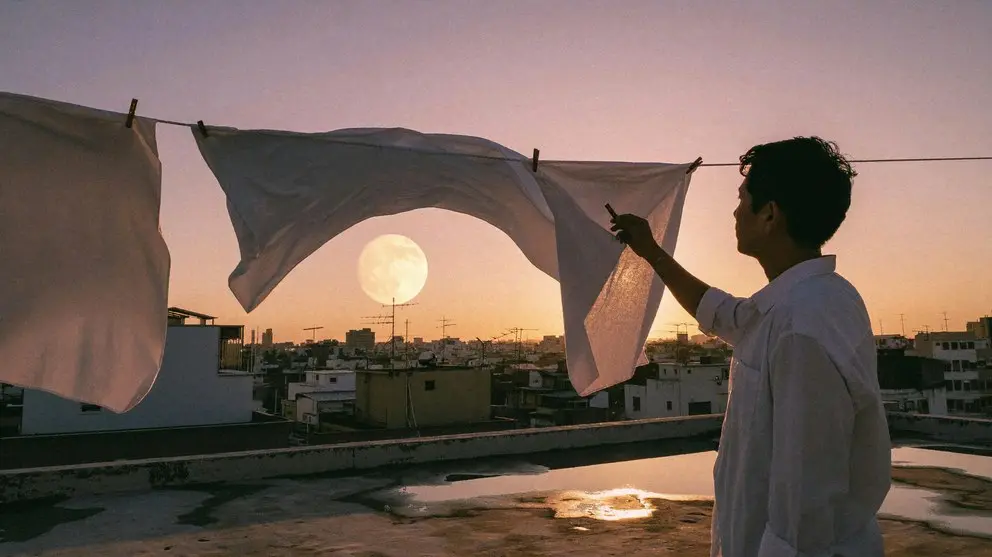
照片是 H3 Image 最擅長的方向:皮膚、布料和光線自然,有真實的景深,沒有常見 AI 圖的塑膠感。像給攝影師下需求一樣寫明鏡頭、時間和氛圍,模型會讓畫面保持真實可信。
可以試試的提示詞
黃昏時分,女人在城市天台上晾白床單,身後升起一輪巨大的滿月,冷暖光交織,35mm 膠片攝影
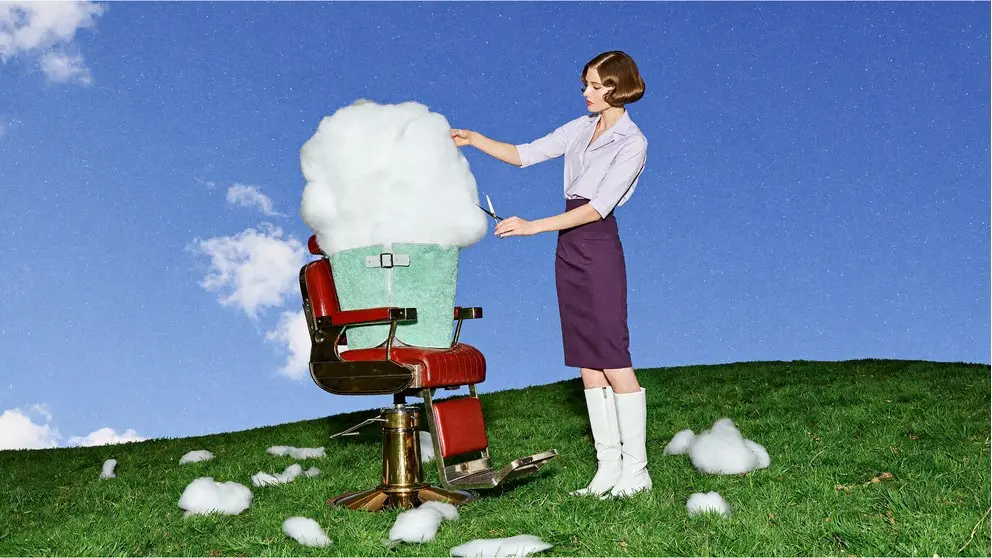
正因為寫實能力強,H3 Image 也能把不可能的創意拍得像真的。給雲朵理髮、從巨大梨子裡走出模特這類超現即時尚創意,依然保有可信的光影、陰影和材質,這正是它看起來有說服力的原因。
可以試試的提示詞
理髮師在紅色理髮椅旁,像修剪顧客頭髮一樣修剪一朵蓬鬆的白雲,綠色草坪,晴朗天空,時尚雜誌大片
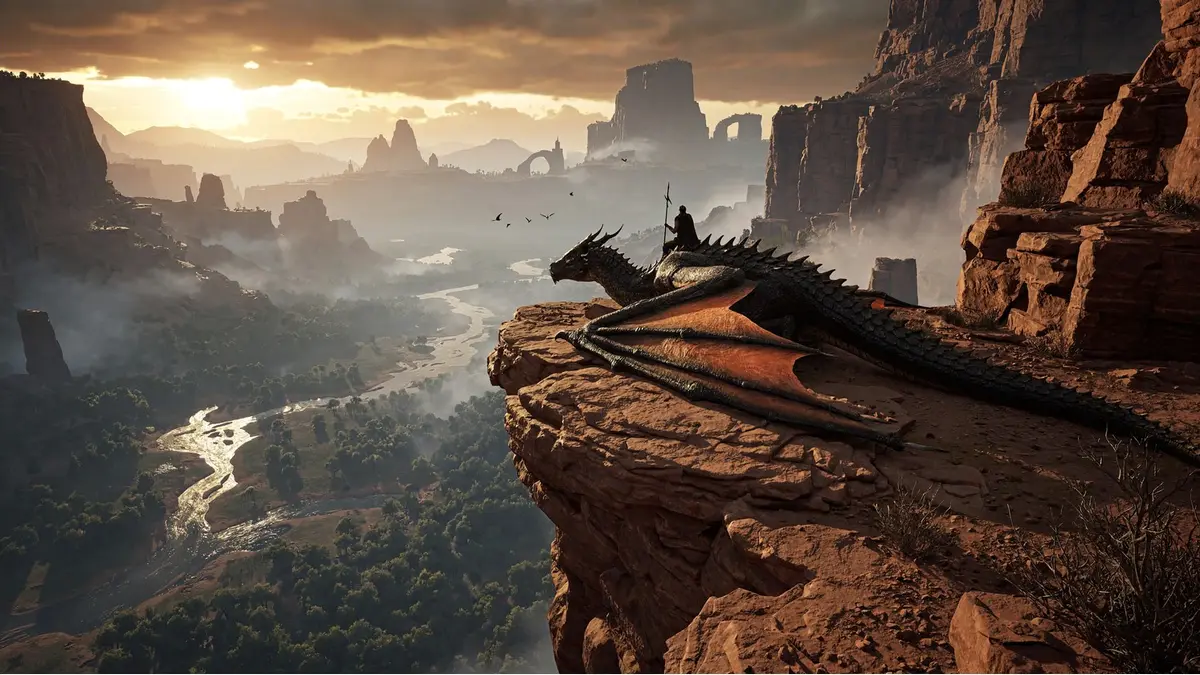
遊戲、影視和分鏡需要的大場景,正適合 4K 輸出。H3 Image 能營造宏大的尺度和氛圍,層次、天氣和光線分明,放大看時人物、遺蹟、招牌等小細節依然清楚。
可以試試的提示詞
黃金時刻,馭龍者站在紅色岩石懸崖上俯瞰遼闊峽谷,史詩奇幻概念設計,遠景
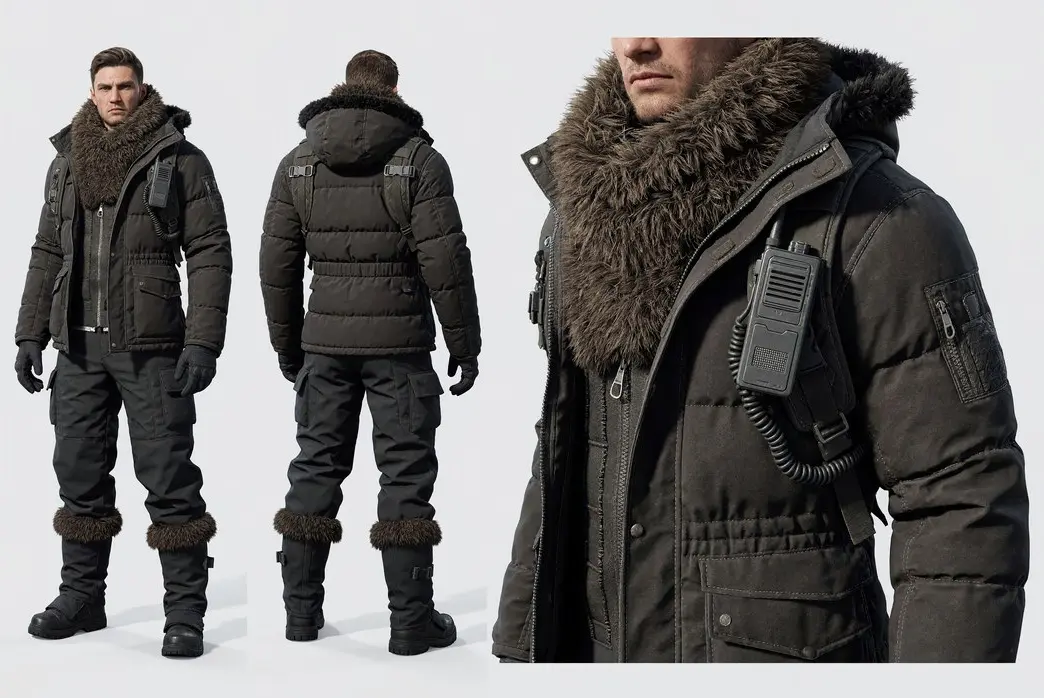
做角色設計時,H3 Image 能輸出接近製作標準的設定圖:正面、背面加服裝細節特寫,彼此保持一致。在 Aniv 上可以儲存結果並作為參考圖使用,讓同一個角色在之後的每個場景和分鏡畫面中保持一致。
可以試試的提示詞
角色設定圖:穿深色毛領冬季派克大衣、掛著對講機的男人,正面、背面和外套特寫,淺色純背景
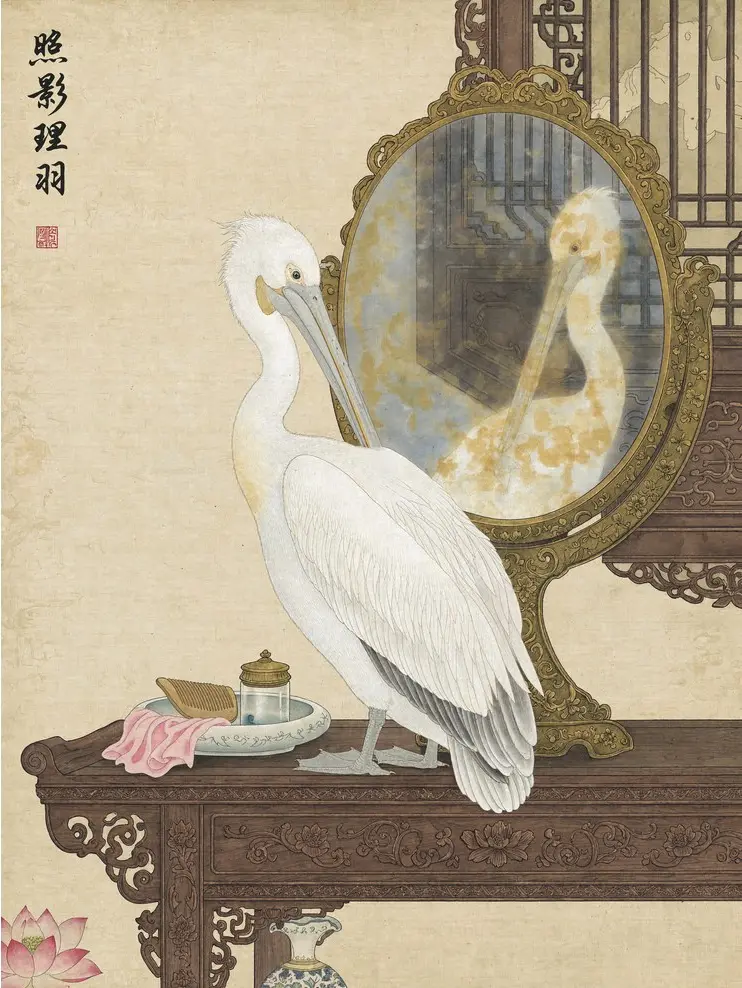
除了照片,H3 Image 對傳統和數字藝術風格也還原得很準,從油畫、淡彩水彩,到塔羅牌插畫和帶書法題字的中國工筆畫。寫明畫種和年代,它會還原筆觸、紙絹質感和構圖習慣,而不是千篇一律的「數字繪畫」感。
可以試試的提示詞
中國工筆畫,一隻鵜鶘望向圓鏡,線條細膩,礦物顏料柔和設色,四字書法題款,絹本質感
圖片來源:MiniMax,取自 Hugging Face 上的 MiniMax H3 Image 官方模型卡與官方釋出部落格。
同一個模型也能改圖。給它一張或多張參考圖,描述想要的結果:該保留的保留,只改你要求的部分。在 Aniv 上最多可新增 16 張參考圖,在提示詞裡用 @ 引用,它們會按新增順序編號為圖1、圖2……
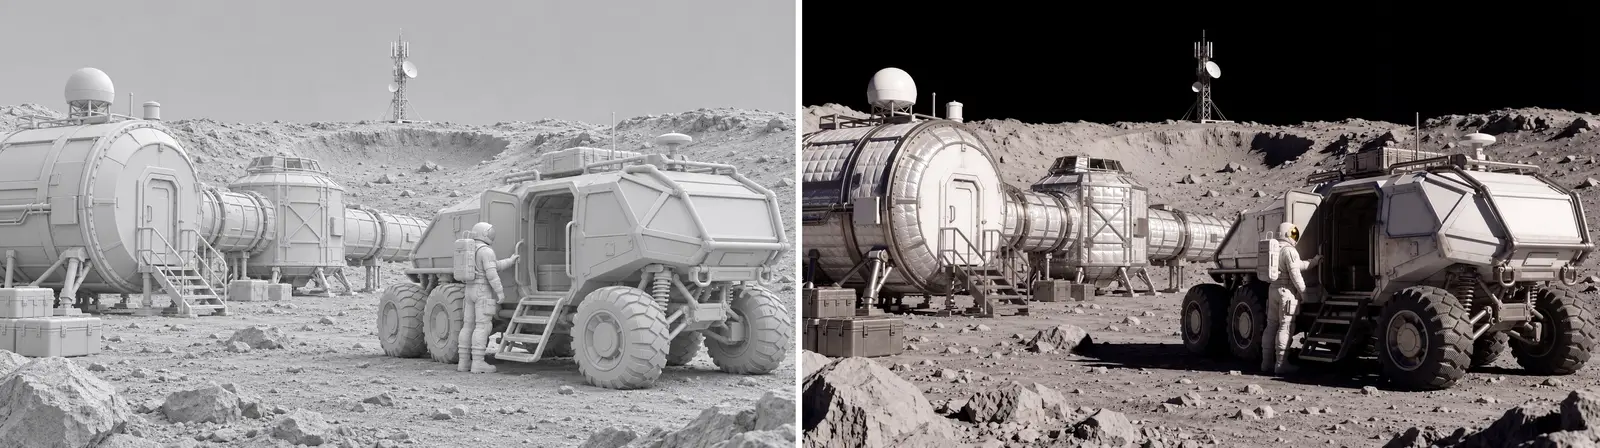
一張沒有材質的月球基地灰模,變成帶材質、光影和陰影的寫實電影劇照,機位和構圖完全不變。用這種方式,可以把 Blender 或遊戲引擎裡的白模快速變成精美主視覺或客戶預覽圖。
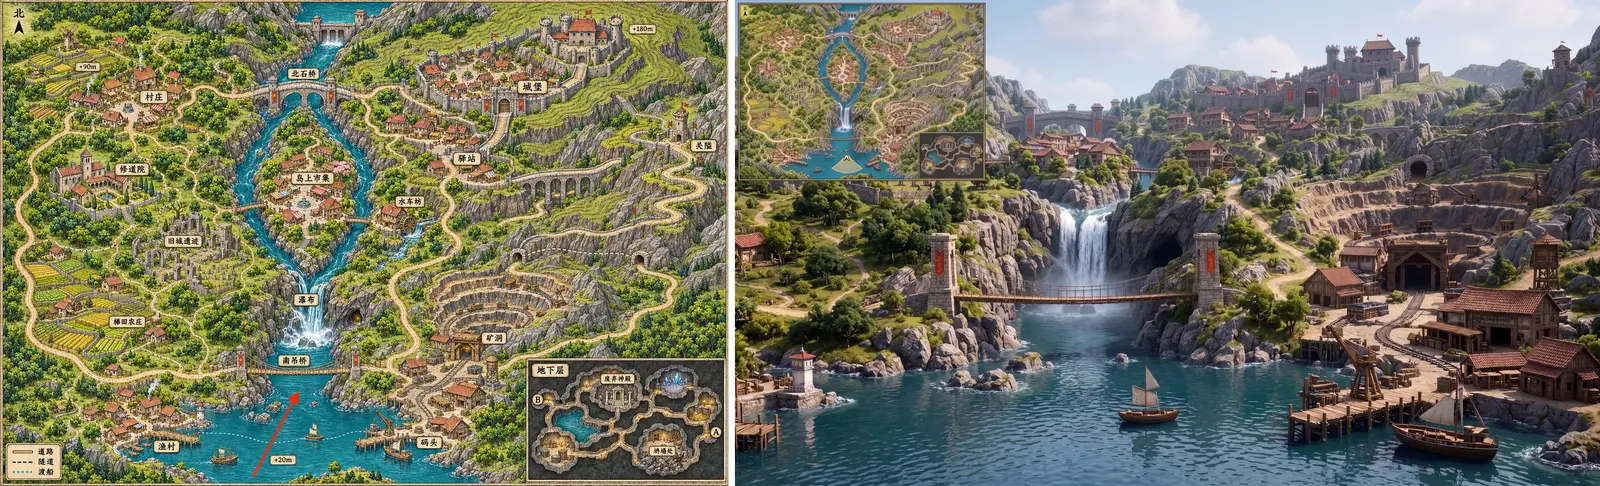
一張手繪遊戲地圖,變成從紅色箭頭位置看出去的第一人稱 3D 畫面,原地圖保留為小地圖。模型必須讀懂地圖上的地形,才能把瀑布、吊橋、礦場和城堡放到正確位置,可見它是在理解參考圖,而不是照搬。
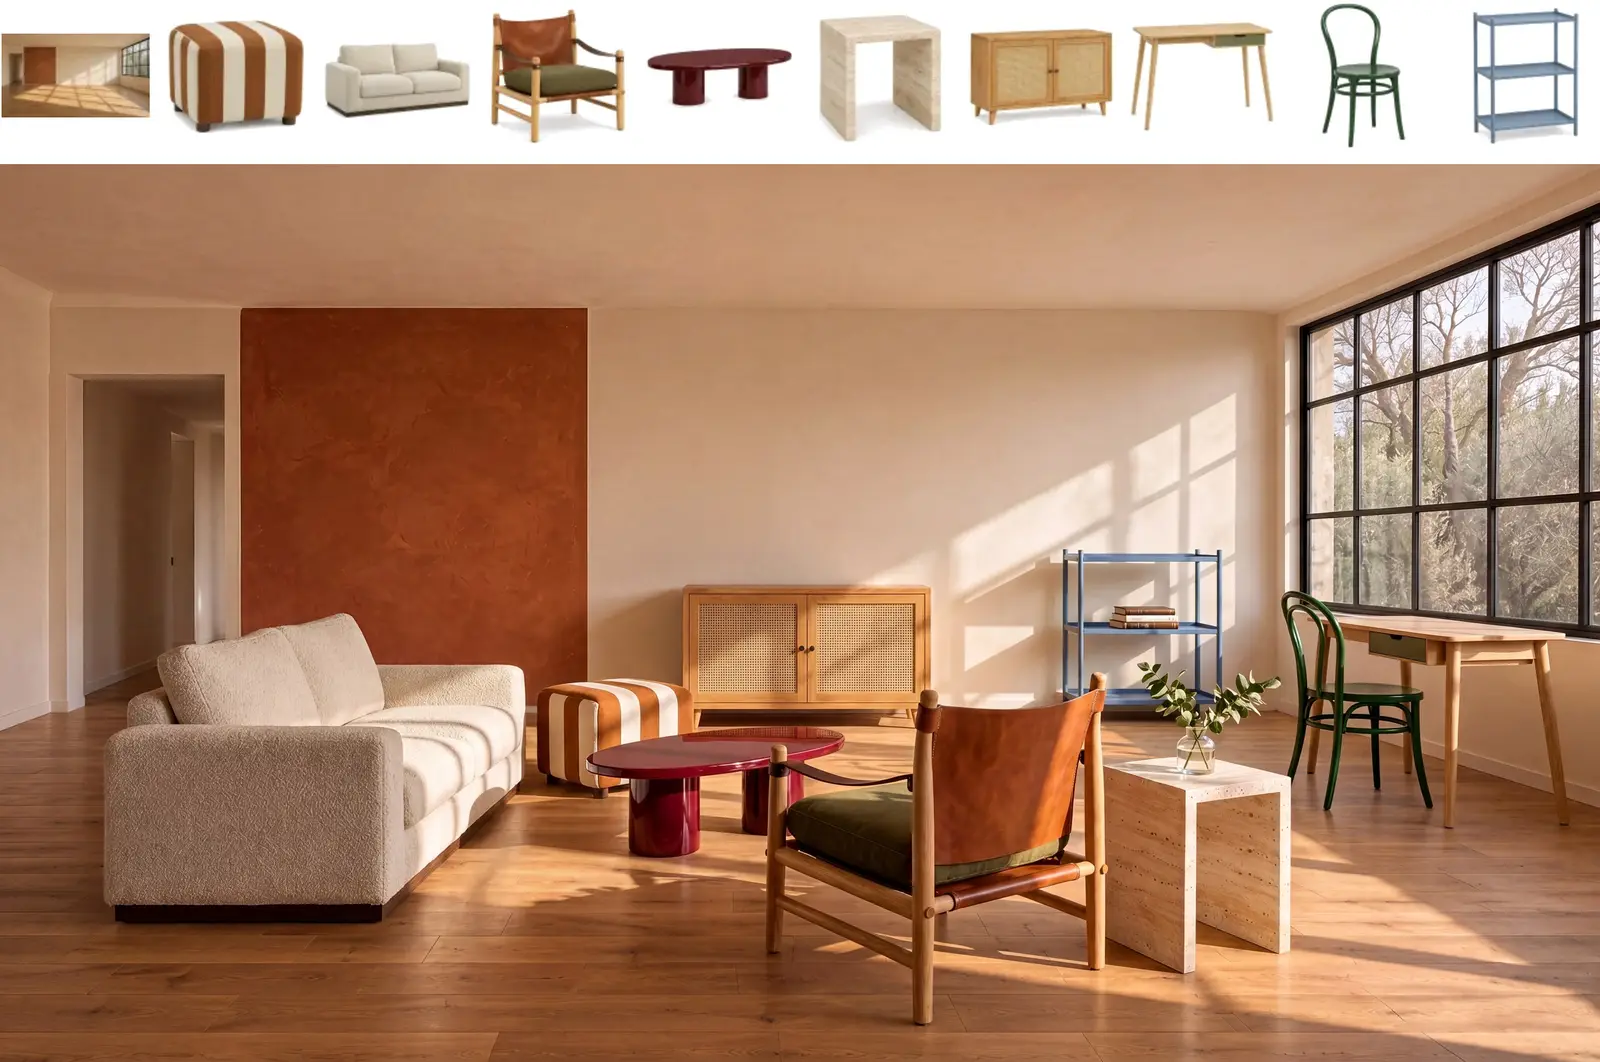
一個空房間加九件傢俱照片,合成為一間佈置完整的客廳,每件傢俱比例合理,並被房間自身的光線照亮。在 Aniv 上每次最多可新增 16 張參考圖,用滿模型支援的上限。
圖片來源:MiniMax,取自 Hugging Face 上的 MiniMax H3 Image 官方模型卡與官方釋出部落格。
這些場景最能發揮 H3 Image 的速度、寫實感和多圖參考編輯能力。
把商品放進精心佈置的場景、替換背景,或做一整套風格統一的商品圖。上傳商品照片作為參考圖,外形、顏色和標籤都能保留。
一次生成畫面和標題文字。4K 輸出留有裁切空間,同一張圖可以用於橫幅、社媒和印刷品。
先用 1K 快速探索場景、生物和道具,再把最好的方向用 4K 出圖,放進提案或美術設定集。
為每個鏡頭生成關鍵幀,用參考圖保持角色一致。在 Aniv 製作 AI 短劇時,分鏡編輯器裡同樣可以選擇 H3 Image。
生成角色的正面、背面和特寫,再把設定圖作為參考圖反覆使用,讓角色在不同場景中保持一致。
用真實傢俱照片佈置空房間,或把灰色 3D 模型渲染成寫實效果圖,快速給客戶預覽。
提示詞最佳化會幫你補全很多內容,但養成幾個習慣能讓結果更可控。
寫清主體、場景、光線、機位和氛圍。畫面描述得越完整,模型需要猜的就越少。
「35mm 膠片攝影」「淡彩水彩」「等距 3D 渲染」「中國工筆畫」這類詞,比「好看」「精美」更能決定畫面風格。
需要出現在畫面上的文字放進引號,並說明放在哪裡、用什麼樣的字型。
用 @ 引用每張上傳的圖,它們會依次成為圖1、圖2……這樣就能寫「把圖3裡的沙發放到圖1的窗邊」。
按最終釋出的位置選好畫幅,用 1K(10 積分)試想法,選中後再用 4K 出最終圖。
寫清哪些必須保持不變、哪些需要修改,例如「保留角色的臉和服裝,把背景換成夜市」。
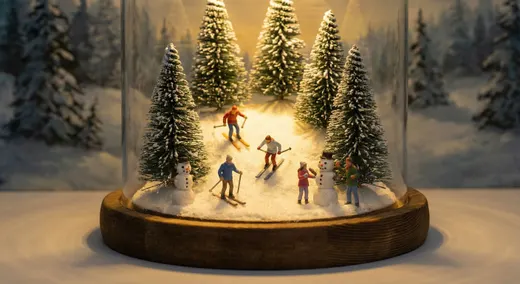
image_example
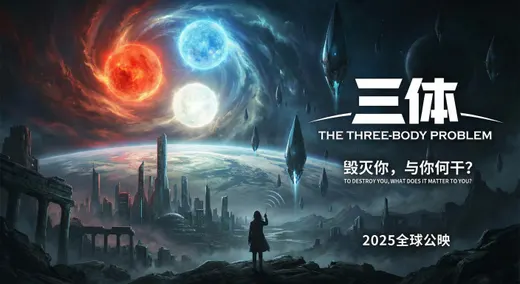
三體宣傳海報
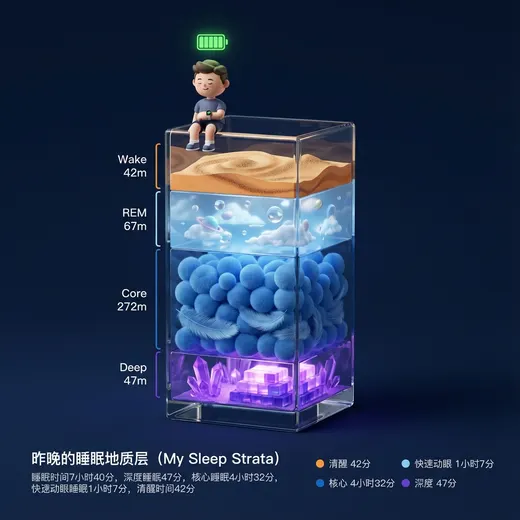
睡眠視覺化
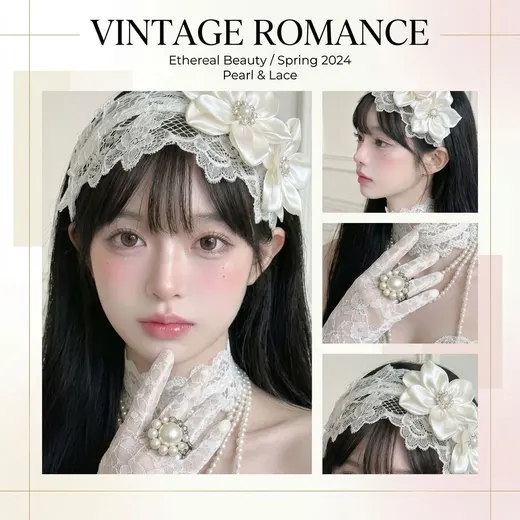
image_example
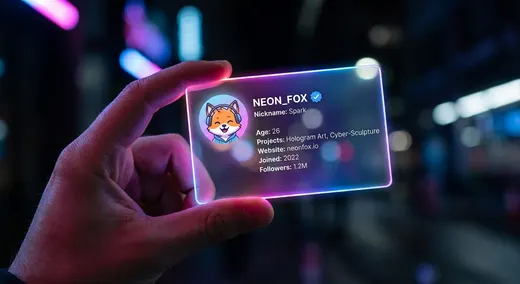
image_example
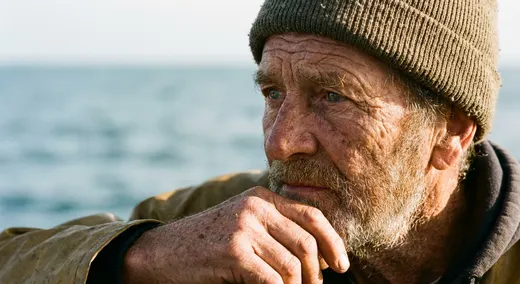
image_example
image_example
MiniMax 官方測試中,H3 Image 標準版生成一張 4096 × 4096 的圖中位耗時約 16 秒,比參與對比的其他模型快數倍;1K、2K 約 10 秒。
皮膚、布料、毛髮和光影都豐富自然,沒有常見 AI 圖那種過度平滑的塑膠感。
提示詞遵循度在開源權重模型中領先,並支援參考圖編輯:給白模換上材質、把多個物件合成到一個場景,或只改一處細節、其餘保持不變。
描述主體、場景、風格以及需要出現在畫面裡的文字。中文短句也可以,生成前會自動擴寫成詳細描述。
最多上傳 16 張參考圖用於編輯或合成,再選擇畫幅(或自動)以及 1K、2K、4K 解析度。
1K、2K、4K 每張分別消耗 10、15、20 積分。檢視結果,按需調整提示詞,滿意後下載。
還有其他問題?請聯絡 support@aniv.ai
MiniMax H3 Image 生成的是單張圖片。想把一個故事做成完整劇集——劇本、一致的角色、分鏡、配音和影片——請使用 Aniv 的 AI 短劇生成器。