 Aniv AI
注册赠送 40 积分
用 MiniMax 开源权重图像模型 MiniMax H3 Image,在线文生图、生成 4K 大图,并上传参考图编辑。
MiniMax H3 Image 是 MiniMax 于 2026 年 11 月 11 日发布的开源权重图像模型。它基于 MiniMax H3,把文生图、参考图生成与图像编辑放进同一个模型,并在所有画幅下原生输出约 1600 万像素。MiniMax 改进了整条后训练链路,从数据、强化学习到减少采样步数、提示词增强和部署优化,让速度、画质与提示词遵循同时提升,而不是此消彼长。
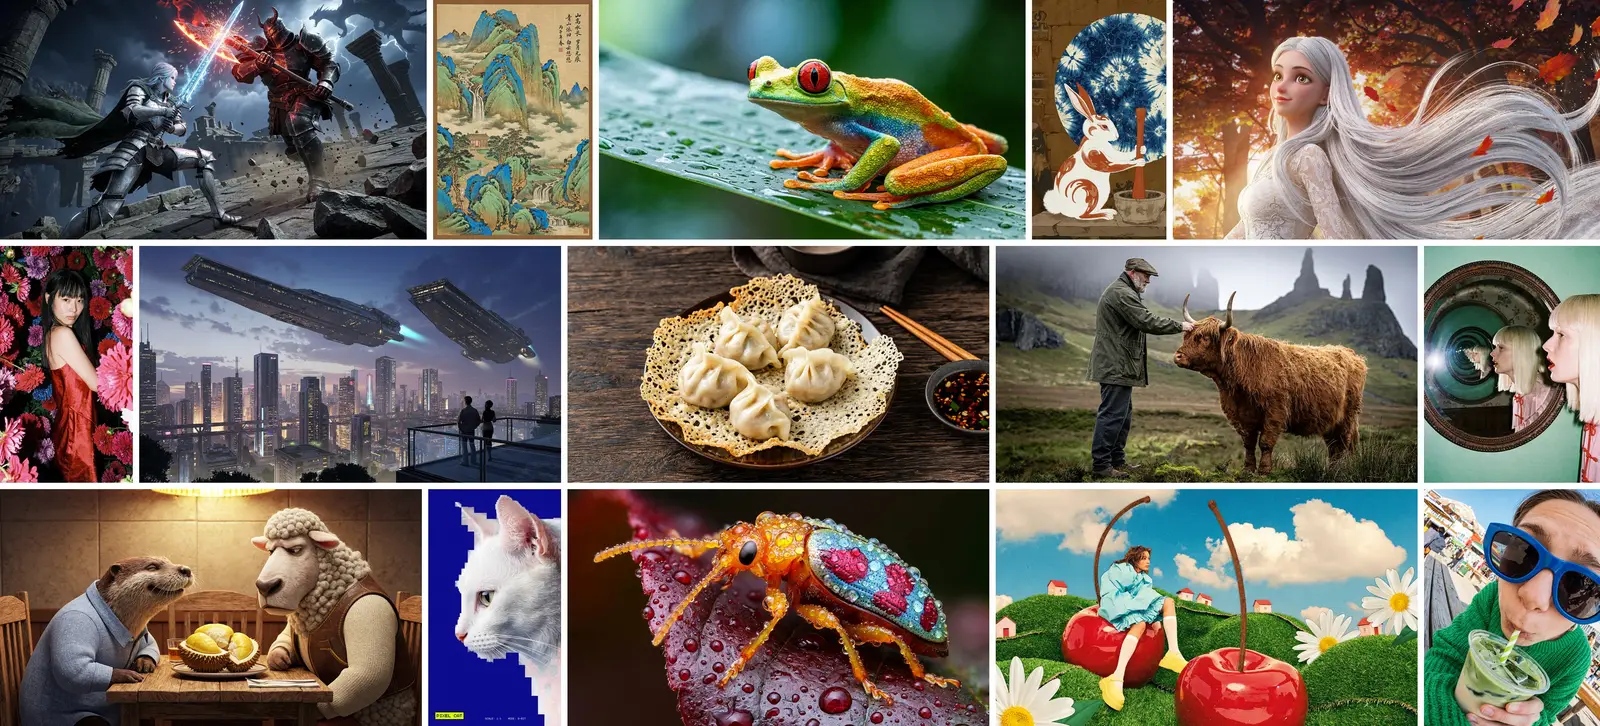
根据 MiniMax 官方发布博客、模型卡,以及 Aniv 所用接口服务商 Evolink 的模型资料,整理 MiniMax H3 Image 的主要特点。
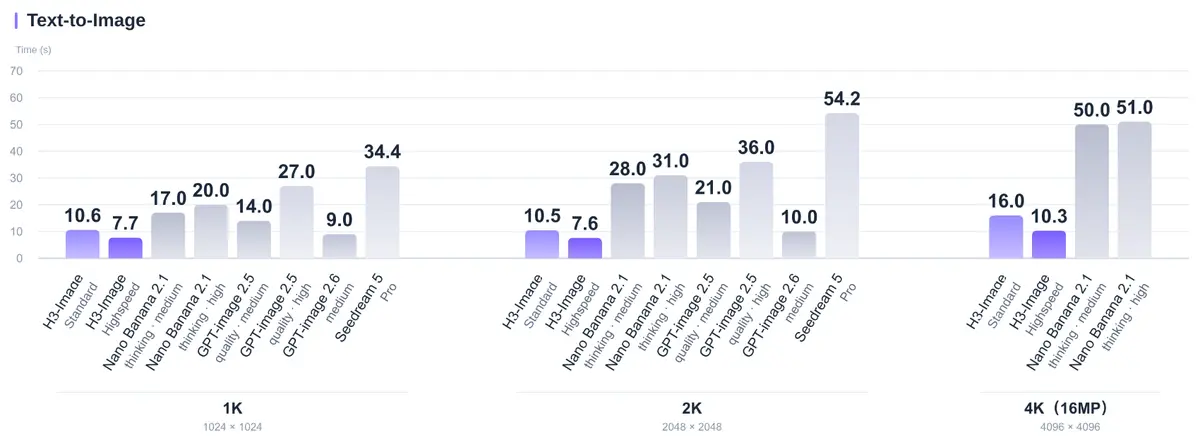
大多数图像模型分辨率一高就明显变慢。MiniMax 官方延迟测试(文生图,中位数)中,H3 Image 标准版 1K、2K 约 10.5 秒,完整 4096 × 4096 的 4K 约 16 秒,而对比中的其他模型生成 4K 需要 50 秒以上。MiniMax 的 Highspeed 极速版可把 4K 压到约 10 秒。
由于 1K 和 2K 耗时几乎一样,反复试稿时也不必为了速度降低分辨率。Aniv 使用的是标准版,排队和保存结果会在 MiniMax 实测时间上再多几秒。
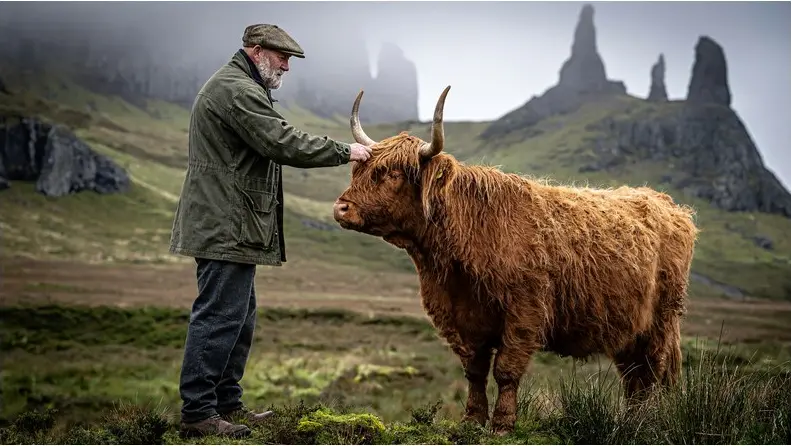
MiniMax 的目标是缩小生成图像与真实世界之间的差距。H3 Image 保留了其他模型容易抹平的细微质感:湿漉漉的毛发、羊毛、饱经风霜的皮肤、布料纹理、山间薄雾。光线也像真实照片那样自然,而不是许多 AI 图那种过亮、过于均匀的光泽感。
分辨率同样重要。模型在所有画幅下都原生输出约 1600 万像素,从 4096 × 4096 方图到 21:9 的 6272 × 2688,不依赖超分放大,细节由模型本身画出,而不是靠后期增强补出来。
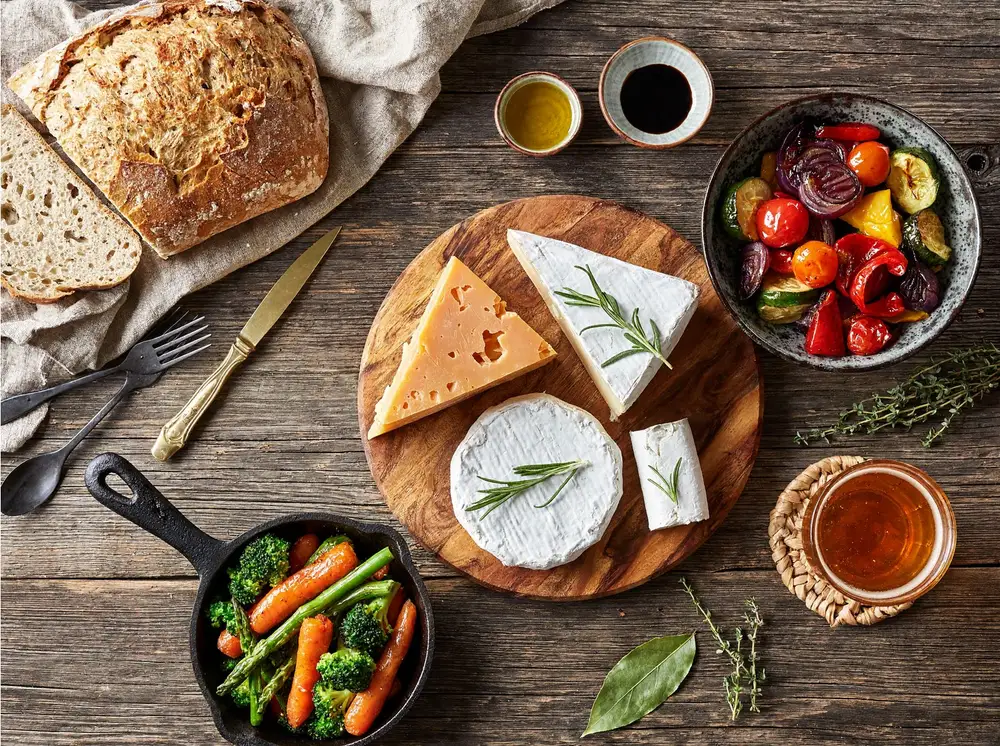
H3 Image 最适合根据一段完整、详细的画面描述来生成,但你不必自己写。生成前,MiniMax 的提示词优化会把任意语言的短提示词扩写成完整描述,涵盖主体、构图、光线、材质和氛围;画幅选「自动」时,还会挑选合适的比例。
这张图就是 MiniMax 官方示例:原始提示词只有一句「俯拍一桌乡村风格的农场直供盛宴」,配上蔬菜、奶酪和面包,生成前被扩写成约 300 词的详细描述。在 Aniv 上提示词优化始终开启,写短句就够了,只在你在意的地方补充细节即可。
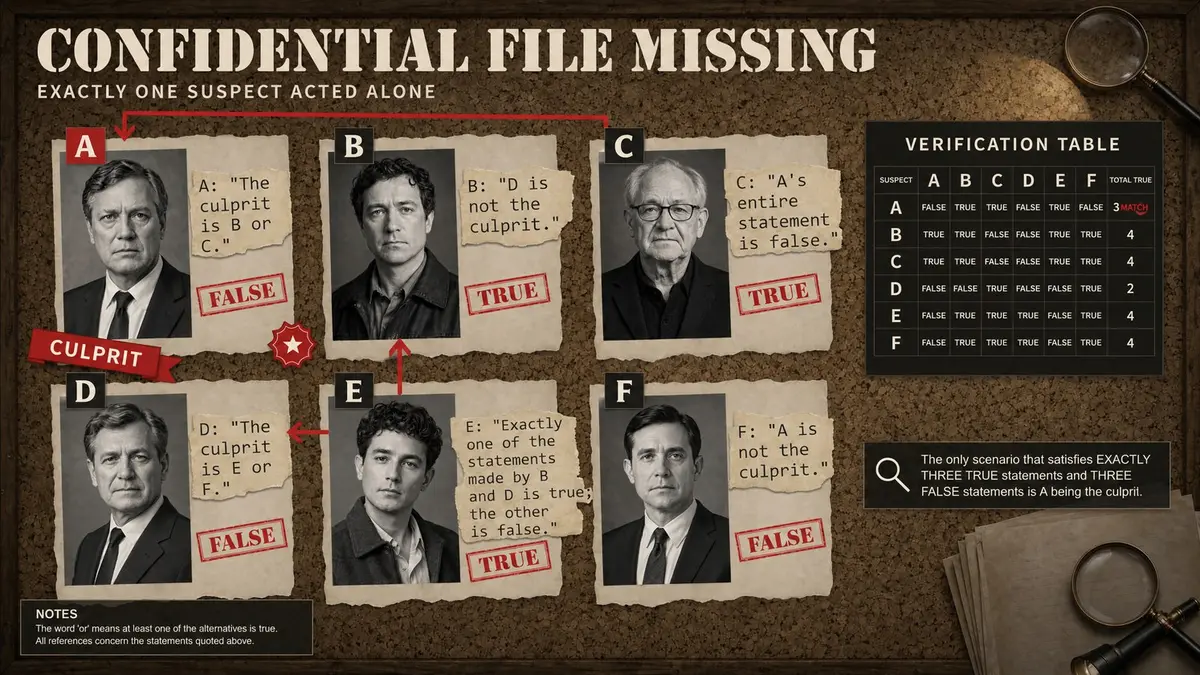
海报、信息图和招牌上的文字既要写对,也要内容正确。H3 Image 能清晰渲染大段中英文,MiniMax 还更进一步:官方示例中,模型在画面上排出整道逻辑推理题,逐条推理并把正确答案写在板上。
因此它适合各种以文字为主的画面,比如菜单、商品标签、活动海报、幻灯片和漫画分格。在提示词里用引号写出准确文字,并说明位置和字体风格。
H3 Image 属于 MiniMax H3 家族,沿用 H3 架构但去掉了音频层:331 亿参数、50 层的扩散 Transformer,H3 文本编码器(基于 Qwen3-VL)和图像 VAE。模型被蒸馏到只需 6 步采样、无需无分类器引导,这也是它速度快的重要原因。
MiniMax 已在 Hugging Face 以 MiniMax-H3-Image 社区许可协议发布权重,支持 diffusers、SGLang、vLLM-Omni 和 ComfyUI。自行部署需要数据中心级 GPU;在 Aniv 上,打开浏览器就能用托管好的模型,无需安装。
以下为 MiniMax 官方样例,每个都附有一句可在上方生成器里直接改写使用的提示词,覆盖从摄影到概念设计、传统绘画等模型擅长的方向。
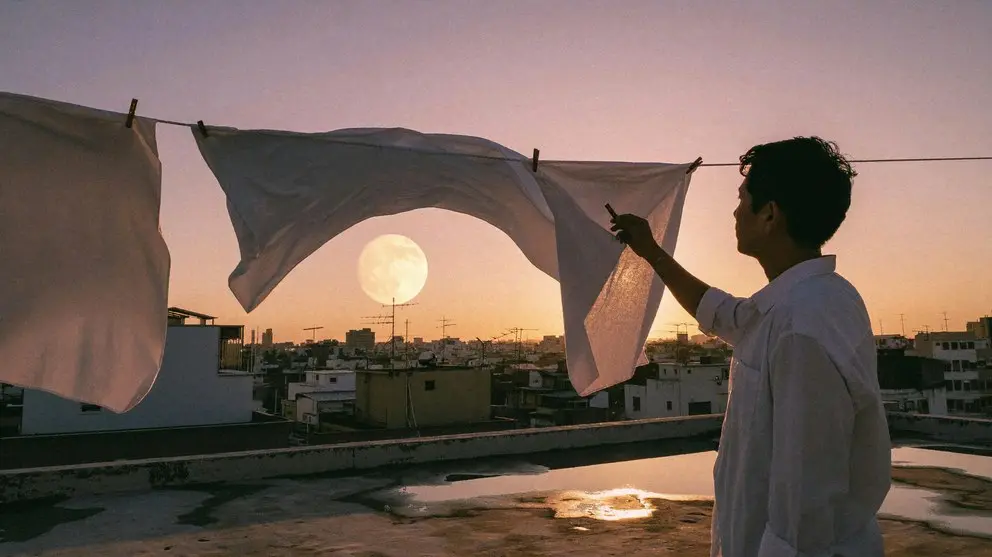
照片是 H3 Image 最擅长的方向:皮肤、布料和光线自然,有真实的景深,没有常见 AI 图的塑料感。像给摄影师下需求一样写明镜头、时间和氛围,模型会让画面保持真实可信。
可以试试的提示词
黄昏时分,女人在城市天台上晾白床单,身后升起一轮巨大的满月,冷暖光交织,35mm 胶片摄影
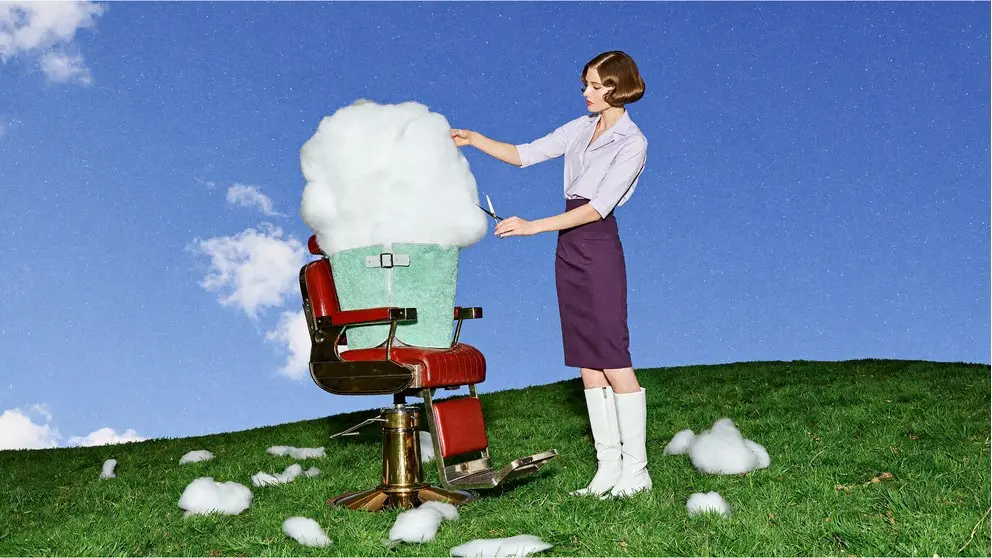
正因为写实能力强,H3 Image 也能把不可能的创意拍得像真的。给云朵理发、从巨大梨子里走出模特这类超现实时尚创意,依然保有可信的光影、阴影和材质,这正是它看起来有说服力的原因。
可以试试的提示词
理发师在红色理发椅旁,像修剪顾客头发一样修剪一朵蓬松的白云,绿色草坪,晴朗天空,时尚杂志大片
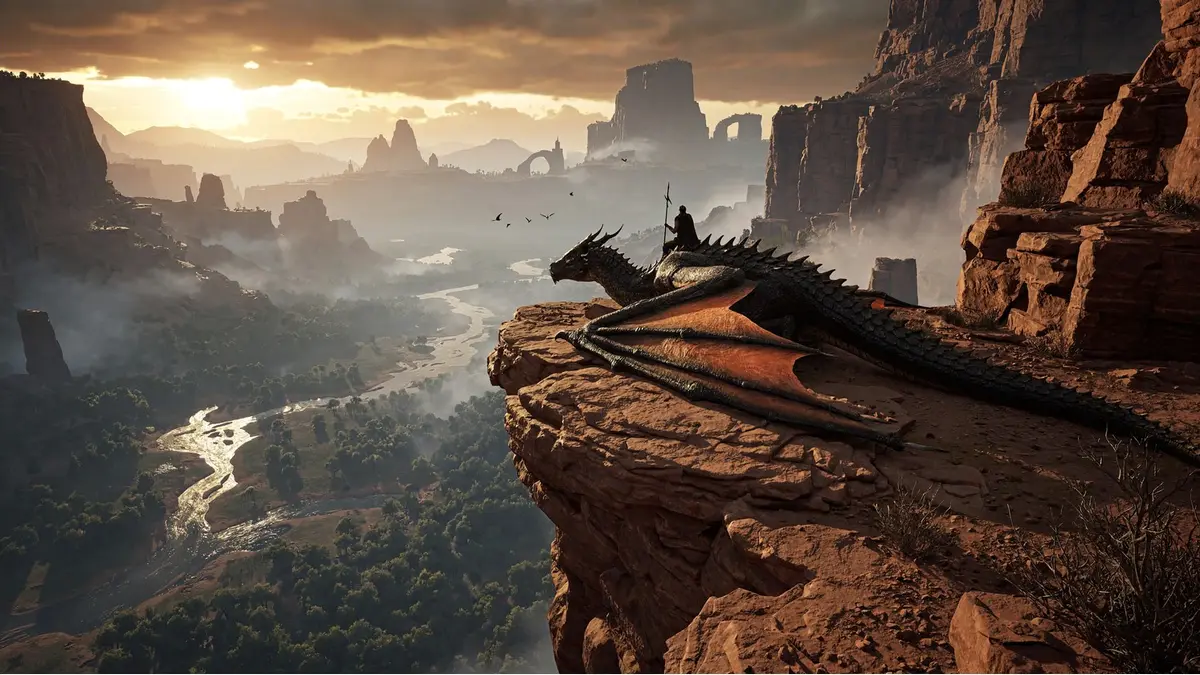
游戏、影视和分镜需要的大场景,正适合 4K 输出。H3 Image 能营造宏大的尺度和氛围,层次、天气和光线分明,放大看时人物、遗迹、招牌等小细节依然清楚。
可以试试的提示词
黄金时刻,驭龙者站在红色岩石悬崖上俯瞰辽阔峡谷,史诗奇幻概念设计,远景
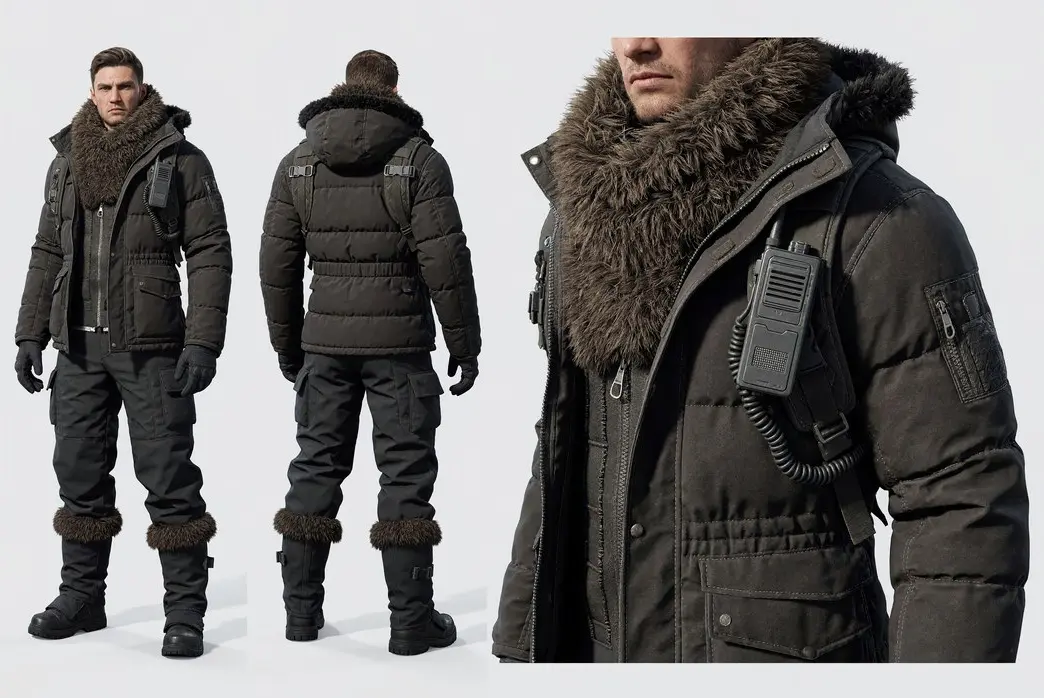
做角色设计时,H3 Image 能输出接近制作标准的设定图:正面、背面加服装细节特写,彼此保持一致。在 Aniv 上可以保存结果并作为参考图使用,让同一个角色在之后的每个场景和分镜画面中保持一致。
可以试试的提示词
角色设定图:穿深色毛领冬季派克大衣、挂着对讲机的男人,正面、背面和外套特写,浅色纯背景
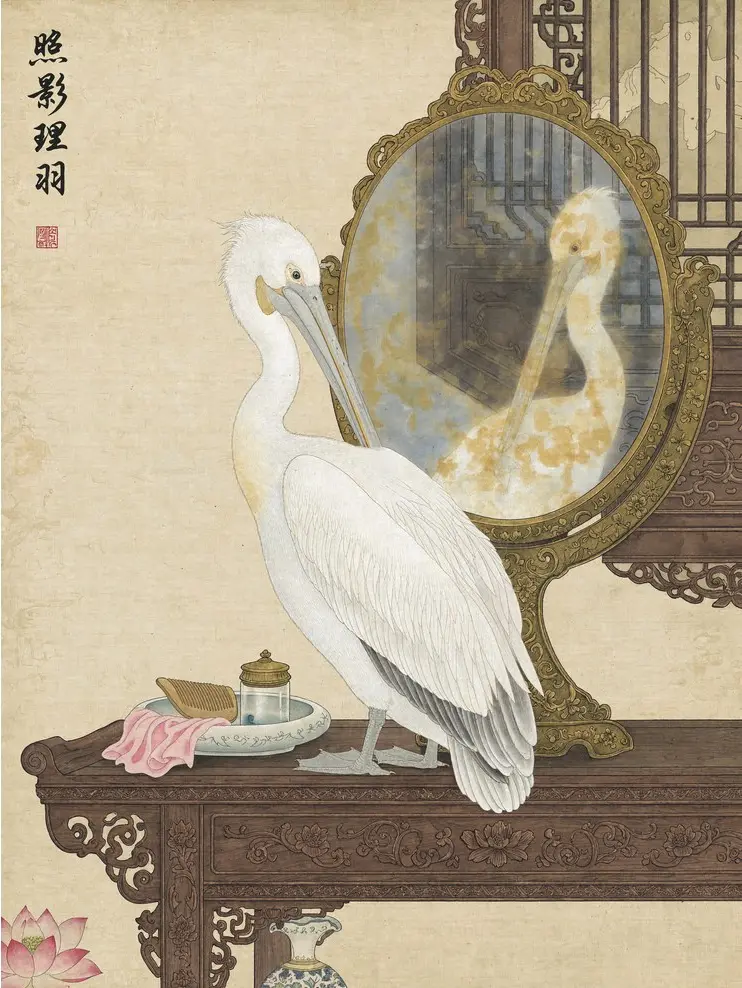
除了照片,H3 Image 对传统和数字艺术风格也还原得很准,从油画、淡彩水彩,到塔罗牌插画和带书法题字的中国工笔画。写明画种和年代,它会还原笔触、纸绢质感和构图习惯,而不是千篇一律的「数字绘画」感。
可以试试的提示词
中国工笔画,一只鹈鹕望向圆镜,线条细腻,矿物颜料柔和设色,四字书法题款,绢本质感
图片来源:MiniMax,取自 Hugging Face 上的 MiniMax H3 Image 官方模型卡与官方发布博客。
同一个模型也能改图。给它一张或多张参考图,描述想要的结果:该保留的保留,只改你要求的部分。在 Aniv 上最多可添加 16 张参考图,在提示词里用 @ 引用,它们会按添加顺序编号为图1、图2……
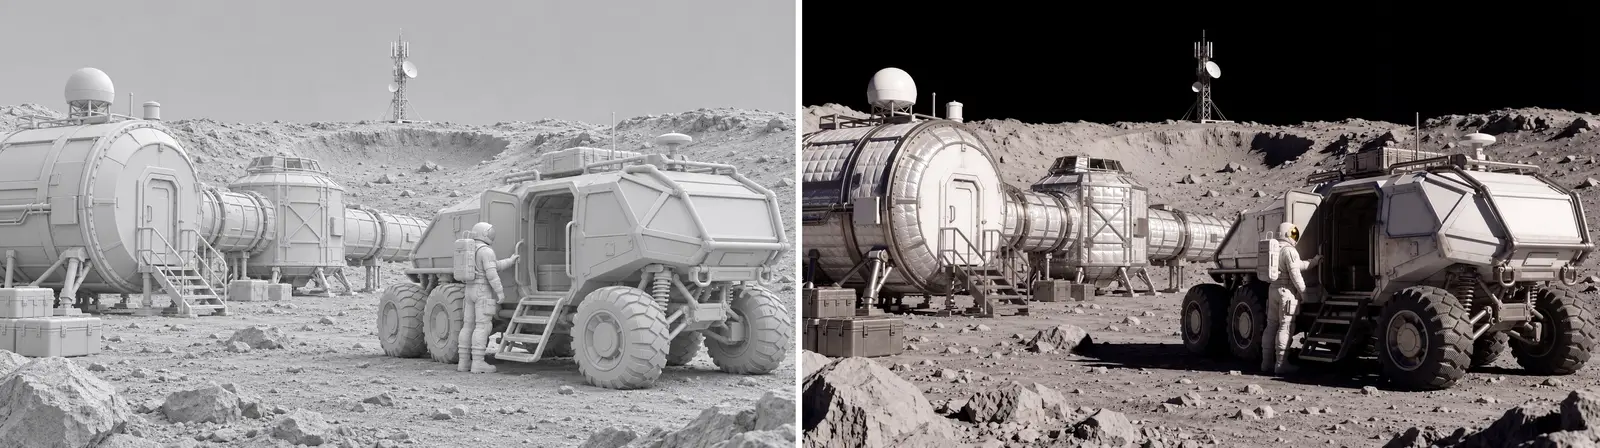
一张没有材质的月球基地灰模,变成带材质、光影和阴影的写实电影剧照,机位和构图完全不变。用这种方式,可以把 Blender 或游戏引擎里的白模快速变成精美主视觉或客户预览图。
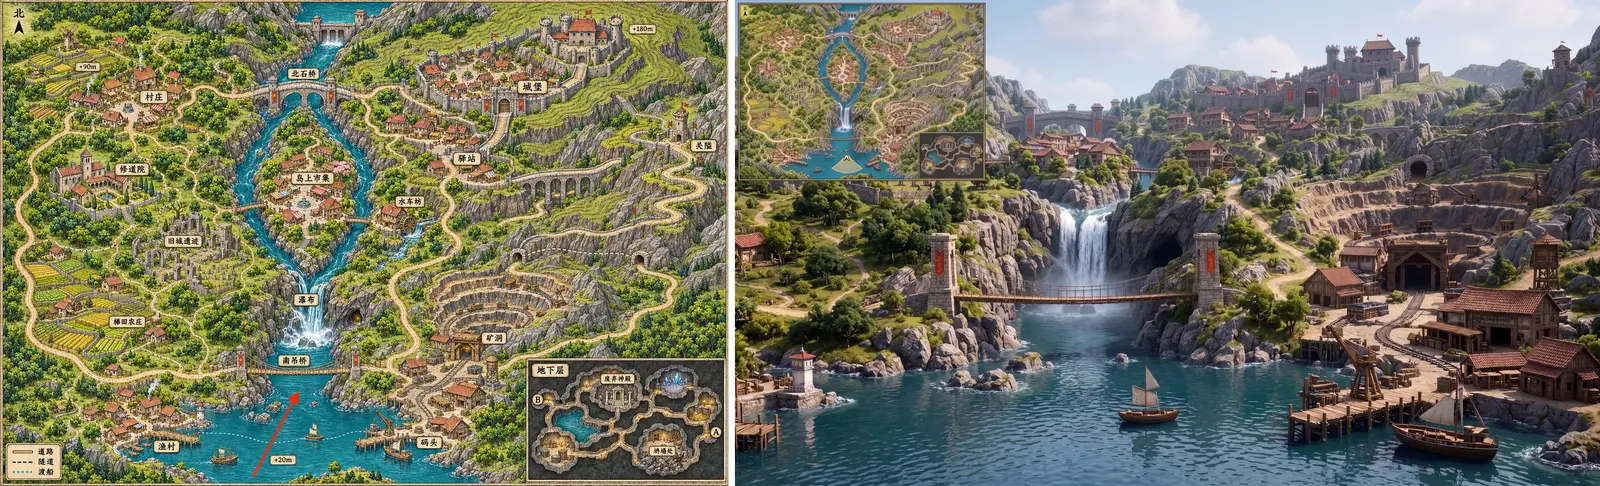
一张手绘游戏地图,变成从红色箭头位置看出去的第一人称 3D 画面,原地图保留为小地图。模型必须读懂地图上的地形,才能把瀑布、吊桥、矿场和城堡放到正确位置,可见它是在理解参考图,而不是照搬。
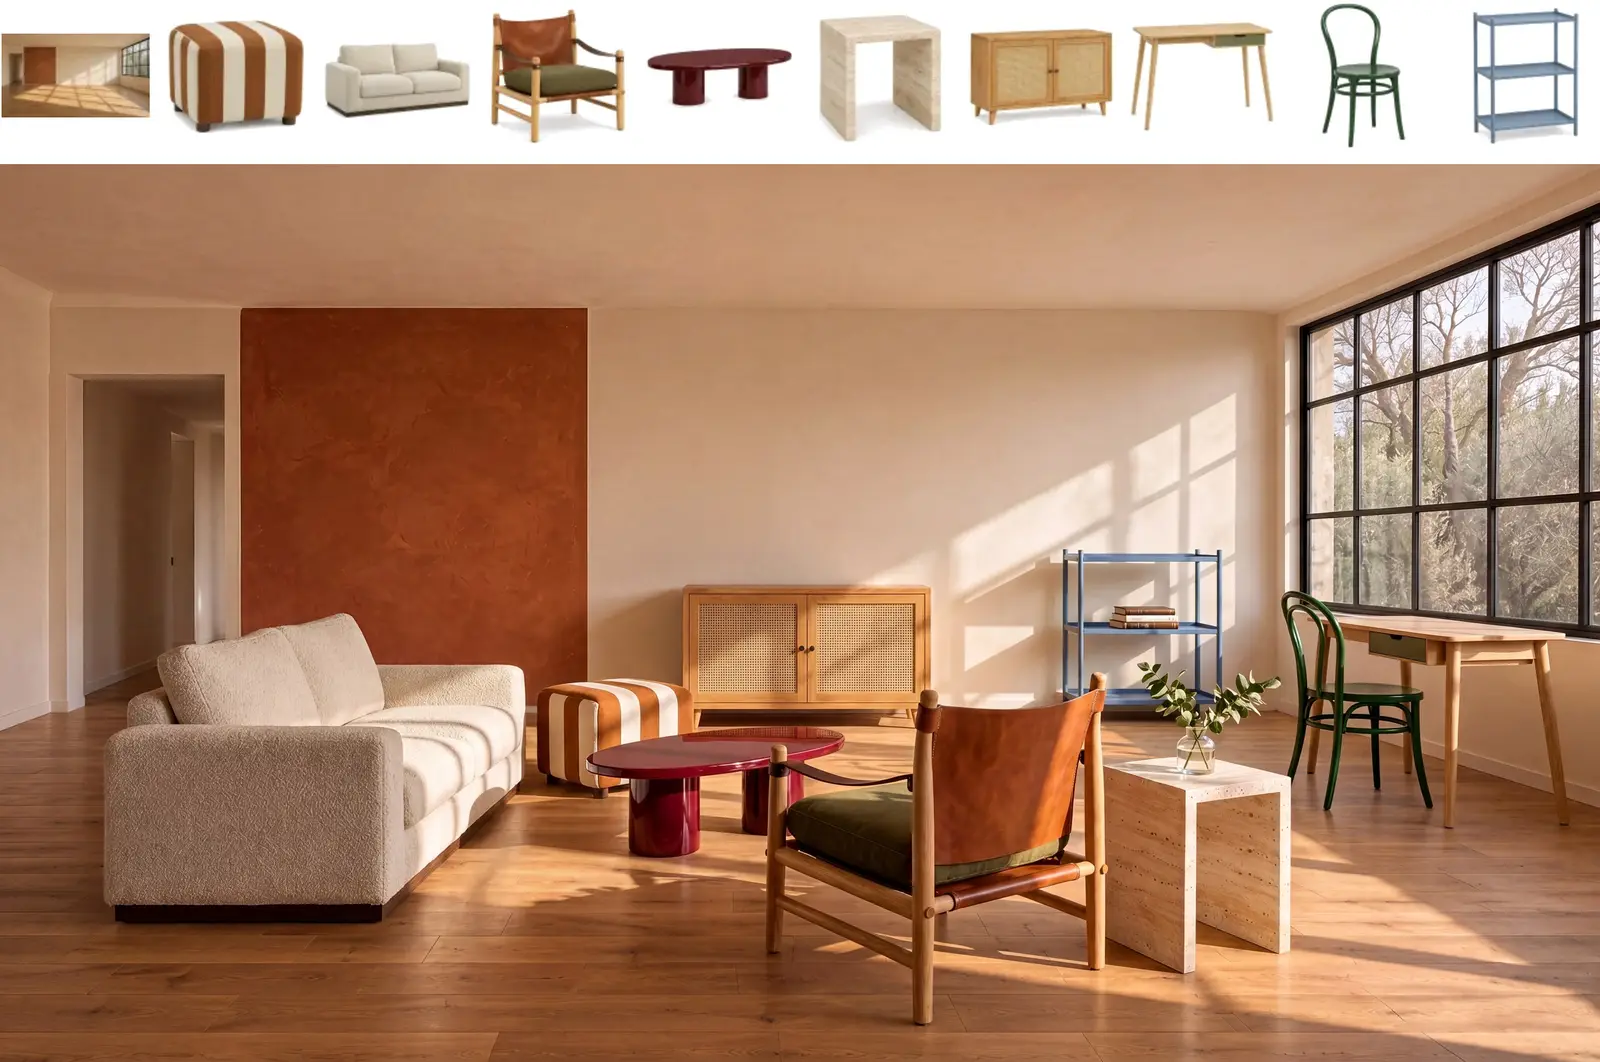
一个空房间加九件家具照片,合成为一间布置完整的客厅,每件家具比例合理,并被房间自身的光线照亮。在 Aniv 上每次最多可添加 16 张参考图,用满模型支持的上限。
图片来源:MiniMax,取自 Hugging Face 上的 MiniMax H3 Image 官方模型卡与官方发布博客。
这些场景最能发挥 H3 Image 的速度、写实感和多图参考编辑能力。
把商品放进精心布置的场景、替换背景,或做一整套风格统一的商品图。上传商品照片作为参考图,外形、颜色和标签都能保留。
一次生成画面和标题文字。4K 输出留有裁切空间,同一张图可以用于横幅、社媒和印刷品。
先用 1K 快速探索场景、生物和道具,再把最好的方向用 4K 出图,放进提案或美术设定集。
为每个镜头生成关键帧,用参考图保持角色一致。在 Aniv 制作 AI 短剧时,分镜编辑器里同样可以选择 H3 Image。
生成角色的正面、背面和特写,再把设定图作为参考图反复使用,让角色在不同场景中保持一致。
用真实家具照片布置空房间,或把灰色 3D 模型渲染成写实效果图,快速给客户预览。
提示词优化会帮你补全很多内容,但养成几个习惯能让结果更可控。
写清主体、场景、光线、机位和氛围。画面描述得越完整,模型需要猜的就越少。
「35mm 胶片摄影」「淡彩水彩」「等距 3D 渲染」「中国工笔画」这类词,比「好看」「精美」更能决定画面风格。
需要出现在画面上的文字放进引号,并说明放在哪里、用什么样的字体。
用 @ 引用每张上传的图,它们会依次成为图1、图2……这样就能写「把图3里的沙发放到图1的窗边」。
按最终发布的位置选好画幅,用 1K(10 积分)试想法,选中后再用 4K 出最终图。
写清哪些必须保持不变、哪些需要修改,例如「保留角色的脸和服装,把背景换成夜市」。
image_example
三体宣传海报
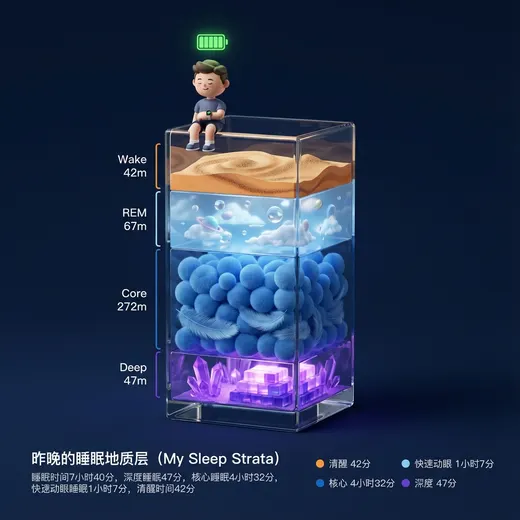
睡眠可视化
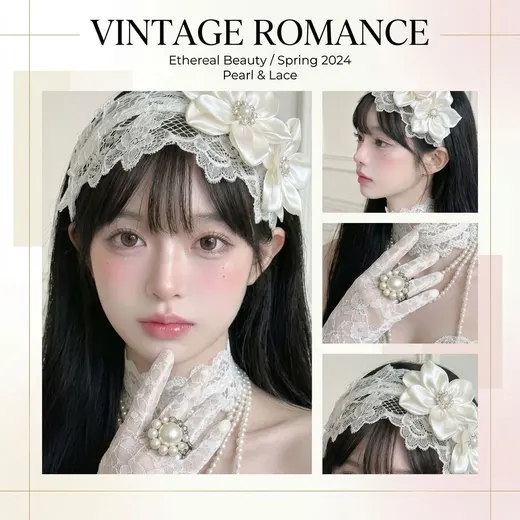
image_example
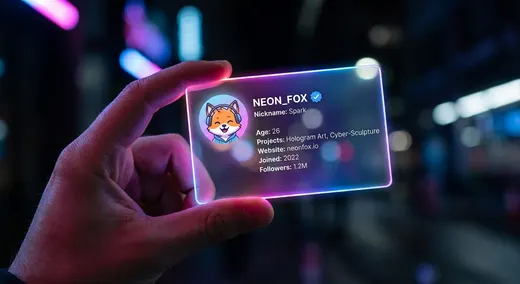
image_example
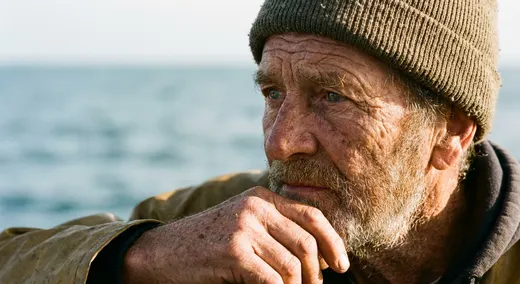
image_example
image_example
MiniMax 官方测试中,H3 Image 标准版生成一张 4096 × 4096 的图中位耗时约 16 秒,比参与对比的其他模型快数倍;1K、2K 约 10 秒。
皮肤、布料、毛发和光影都丰富自然,没有常见 AI 图那种过度平滑的塑料感。
提示词遵循度在开源权重模型中领先,并支持参考图编辑:给白模换上材质、把多个物件合成到一个场景,或只改一处细节、其余保持不变。
描述主体、场景、风格以及需要出现在画面里的文字。中文短句也可以,生成前会自动扩写成详细描述。
最多上传 16 张参考图用于编辑或合成,再选择画幅(或自动)以及 1K、2K、4K 分辨率。
1K、2K、4K 每张分别消耗 10、15、20 积分。查看结果,按需调整提示词,满意后下载。
还有其他问题?请联系 support@aniv.ai
MiniMax H3 Image 生成的是单张图片。想把一个故事做成完整剧集——剧本、一致的角色、分镜、配音和视频——请使用 Aniv 的 AI 短剧生成器。