 Aniv AI
01
텍스트만으로 영상 생성
원하는 장면 — 구도, 동작, 분위기 — 을 적으면 그 설명대로 카메라 워크가 들어간 클립이 만들어집니다. 준비할 소재가 없습니다.
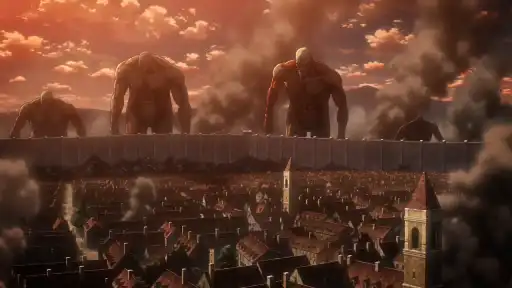
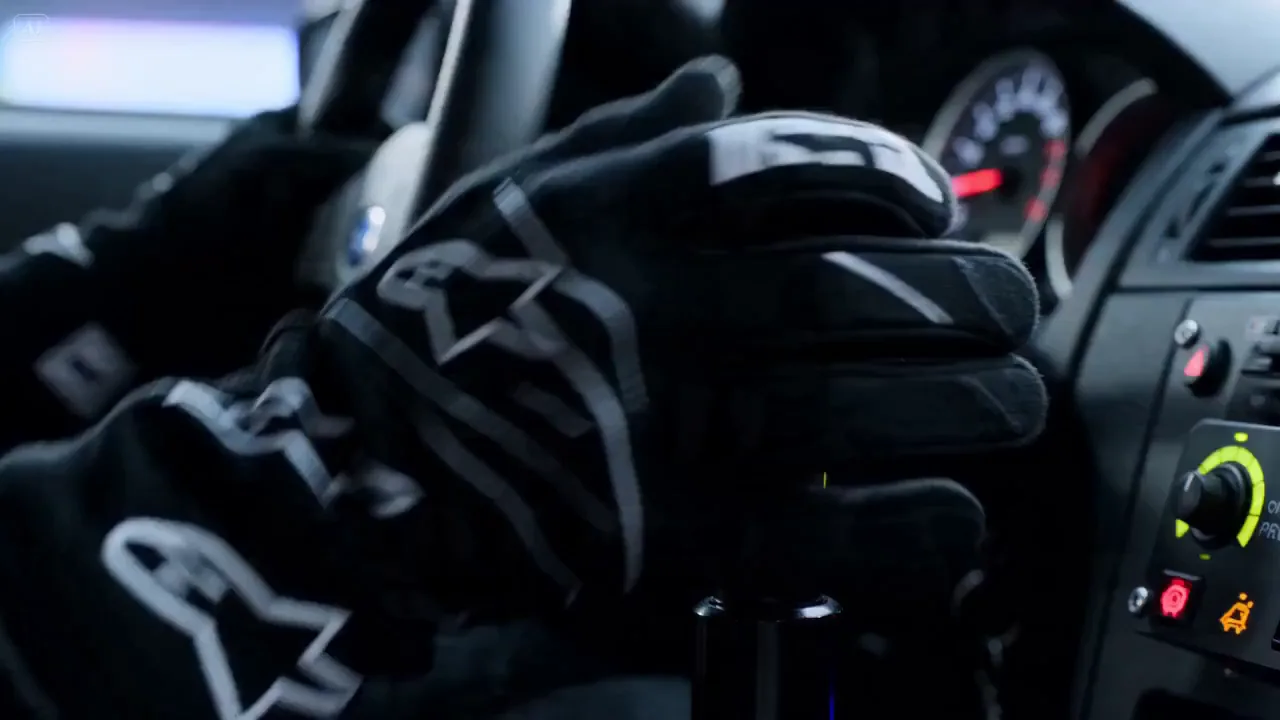
Car in motion
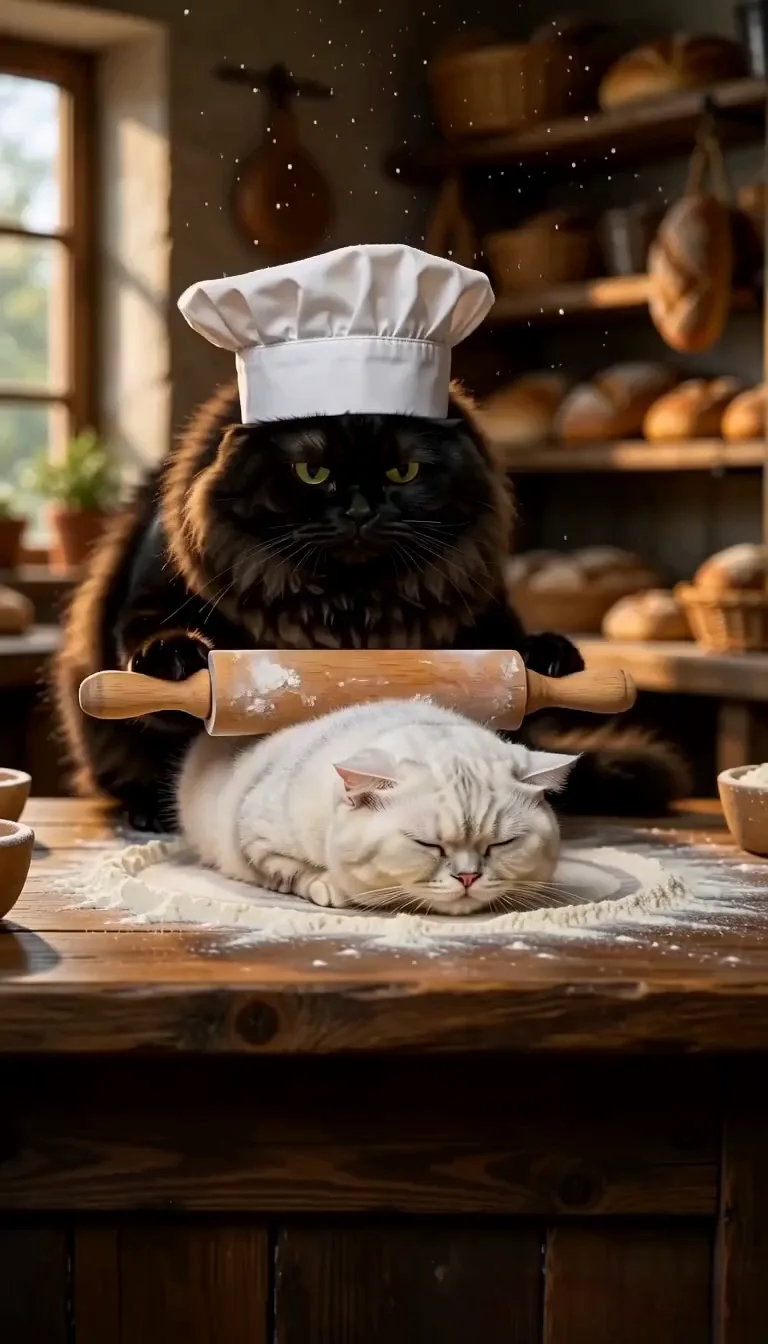
한 문장부터 참조 이미지까지, 네 가지 입력 방식이 아이디어에서 완성본까지의 과정을 모두 아우릅니다.
01
원하는 장면 — 구도, 동작, 분위기 — 을 적으면 그 설명대로 카메라 워크가 들어간 클립이 만들어집니다. 준비할 소재가 없습니다.
02
시작 화면으로 이미지를 올리면 그 프레임에서 영상이 움직이기 시작합니다. 화면 비율이 이미지를 따르므로 구도와 색감이 그대로 유지됩니다.
03
이미지를 첫 프레임이 아니라 내용 참조로 사용합니다. 배경과 스타일, 요소를 가져오되 텍스트 지시에 맞춰 화면을 다시 구성합니다.
04
캐릭터 참조를 넣으면 컷이 바뀌어도 같은 인물의 얼굴과 의상, 체형이 유지됩니다. 클립을 한 편의 드라마로 잇기 위한 전제입니다.
정적인 이미지에 역동적인 움직임을 더해 생동감 있게 만듭니다.
장면을 완전히 이해하는 텍스트 프롬프트만으로 영상을 생성합니다.
일부 모델은 동기화된 오디오를 자동으로 생성해 후반 작업이 필요 없습니다.
Seedance 2.0과 Kling O3는 이미지, 영상 클립, 오디오 참고를 결합해 더 강력한 시각·움직임 제어로 새 영상을 생성합니다.
빠른 소셜 클립부터 영화적 4K 제작까지, 모든 용도를 아우르는 최첨단 모델 6종.
ByteDance의 최신 세대 모델. 네이티브 멀티샷 캐릭터 일관성, 네이티브 오디오, 최대 15초 길이를 갖춘 내러티브 숏폼 콘텐츠 전용 모델입니다.
AI가 생성한 인물 이미지를 참고 이미지로 포함해 사실적인 인물 참고 생성을 지원합니다.
Seedance 참고 자료 제한
ByteDance의 속도 최적화 Seedance 모델. 오디오, 캐릭터 일관성, 긴 길이 등 Seedance 2.0의 핵심 기능을 더 빠르고 저렴하게 제공합니다.
AI가 생성한 인물 이미지를 참고 이미지로 포함해 사실적인 인물 참고 생성을 지원합니다.
Seedance 참고 자료 제한
Kuaishou의 옴니 플래그십 모델. 하나의 프롬프트에서 이미지·영상 클립·오디오 참고를 받아들여 고도로 제어 가능한 멀티모달 영상 생성을 제공합니다.
Kling O3 참고 자료 제한
Kuaishou의 플래그십 영상 모델. 폭넓은 화면 비율 지원, 부드러운 움직임, 선택적 오디오 생성을 갖춘 범용 영상 제작에 최적입니다.
Kling V3 참고 자료 제한
Google DeepMind의 대표 영상 모델. 네이티브 오디오 생성, 최대 4K 해상도, 강력한 프롬프트 준수로 뛰어난 영화적 품질을 제공합니다. 고급 제작에 이상적입니다.
Veo 3.1의 속도 최적화 버전. 동일한 4K 성능과 네이티브 오디오를 유지하면서 훨씬 빠르게 생성합니다. 작업 속도가 중요할 때 안성맞춤입니다.
참고 이미지를 업로드하거나 텍스트 프롬프트를 입력하세요.
모델, 길이, 해상도, 오디오 옵션을 선택하세요.
영상을 생성하고 결과물을 다운로드하세요.
다른 궁금한 점이 있나요? support@aniv.ai 로 문의하세요