 Aniv AI
01
Генерация из любого текста
Опишите нужный кадр — план, движение, настроение — и модель соберёт клип с камерой по этому описанию. Никаких материалов готовить не нужно.
Создавайте интересные видеоролики с помощью ИИ
Car in motion
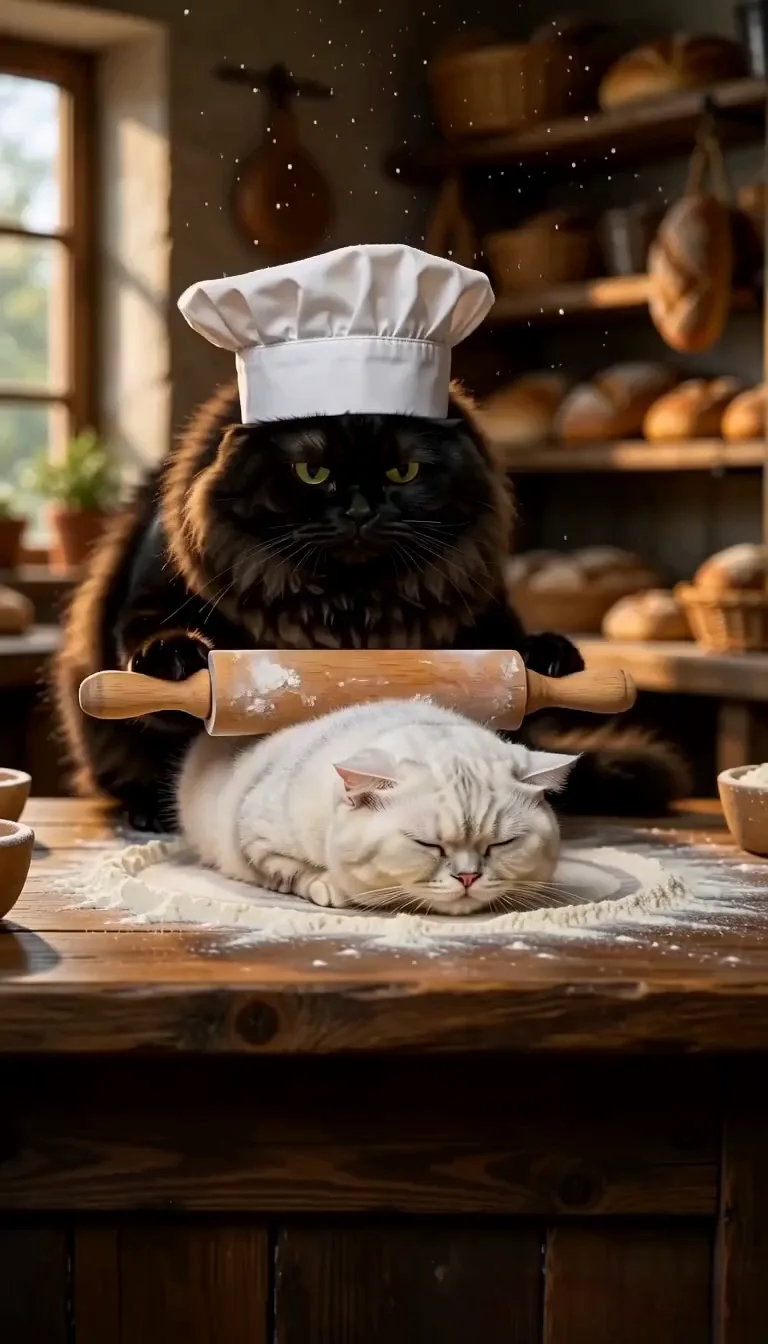
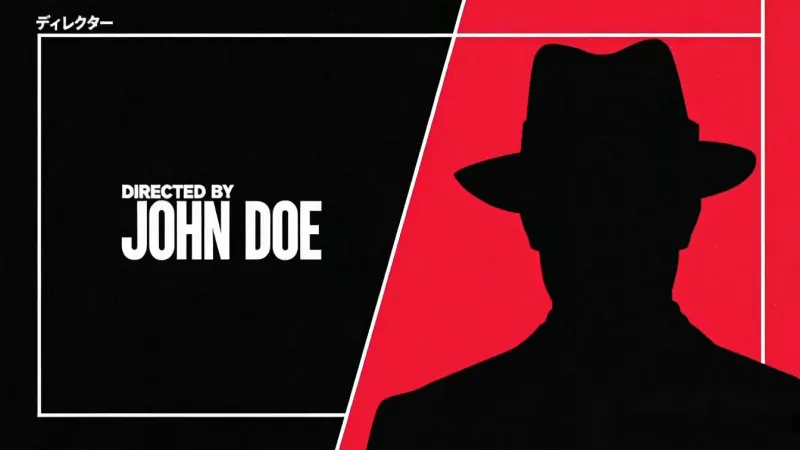
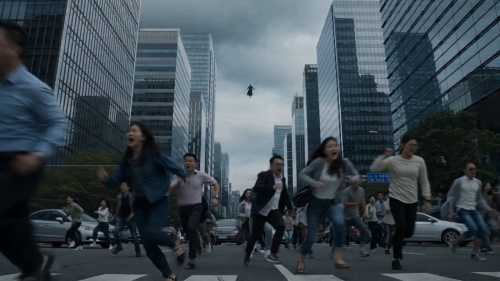
От одной фразы до референсного изображения — четыре способа ввода покрывают весь путь от идеи до готового ролика.
01
Опишите нужный кадр — план, движение, настроение — и модель соберёт клип с камерой по этому описанию. Никаких материалов готовить не нужно.
02
Загрузите картинку как стартовый кадр, и видео пойдёт именно с него. Соотношение сторон следует за этим изображением, поэтому композиция и цвет сохраняются.
03
Используйте картинку как референс содержания, а не как первый кадр. Модель берёт из неё обстановку, стиль и детали и заново выстраивает кадр по вашему промпту.
04
Передайте референс персонажа — лицо, одежда и телосложение останутся прежними от кадра к кадру. Без этого клипы не сложатся в цельную драму.
Оживите свои статические изображения с помощью динамической генерации движения.
Создавайте видео непосредственно из текстовых подсказок с полным пониманием сцены.
Некоторые модели автоматически генерируют синхронизированный звук — постобработка не требуется.
Seedance 2.0 и Kling O3 могут объединять изображения, видеоклипы и аудио-отсылки для создания нового видео с более сильным визуальным контролем и контролем движения.
Шесть современных моделей, охватывающих любые варианты использования — от быстрых видеороликов для социальных сетей до кинематографических фильмов в формате 4K.
Модель последнего поколения ByteDance. Имеет встроенную согласованность персонажей из нескольких кадров, собственный звук и продолжительность до 15 секунд — специально создано для короткометражного повествовательного контента.
Поддерживает реалистичное создание эталонных изображений человека, включая изображения людей, созданные искусственным интеллектом, в качестве эталонных изображений.
Ограничения референсов Seedance
Модель Seedance от ByteDance, оптимизированная по скорости. Все основные возможности Seedance 2.0 — звук, согласованность символов, большая продолжительность — при более быстром выполнении и меньших затратах.
Поддерживает реалистичное создание эталонных изображений человека, включая изображения людей, созданные искусственным интеллектом, в качестве эталонных изображений.
Ограничения референсов Seedance
Флагманская модель Omni от Kuaishou. Принимает изображения, видеоклипы и звуковые ссылки в одном запросе, обеспечивая легко управляемую мультимодальную генерацию видео.
Ограничения референсов Kling O3
Флагманская видеомодель Kuaishou. Высокая универсальность, поддержка широкого формата изображения, плавное движение и дополнительная генерация звука. Лучше всего подходит для создания видео общего назначения.
Ограничения референсов Kling V3
Лучшая видеомодель Google DeepMind. Обеспечивает исключительное кинематографическое качество с собственной генерацией звука, разрешением до 4K и быстрым соблюдением требований. Идеально подходит для производства высококачественных материалов.
Версия Veo 3.1, оптимизированная по скорости. Те же возможности 4K и собственный звук со значительно более быстрой генерацией — идеально, когда время обработки имеет значение.
Загрузите эталонное изображение или введите текстовую подсказку.
Выберите модель, продолжительность, разрешение и параметры звука.
Создайте свое видео и загрузите результат.
Есть еще вопросы? Свяжитесь с нами по адресу support@aniv.ai